llms.txt es un archivo Markdown que se publica en la raíz de una web para dar a los modelos de lenguaje un índice de sus páginas más útiles. Se crea en diez minutos. A 22 de septiembre de 2026, ni Google ni OpenAI, Anthropic o Perplexity han dicho que lo usen para decidir a quién citar.
La última frase casi nunca aparece en las guías que explican cómo crearlo. Nosotros publicamos el nuestro el 3 de septiembre, con la web nueva, y desde entonces hemos contado en los logs del servidor quién lo pide. En diecinueve días, los rastreadores de OpenAI, Anthropic y Perplexity pasaron por auroraglobalgroup.com todos los días, con más de dos mil peticiones entre los tres, y ninguna fue a llms.txt. Aquí va qué es el archivo, qué dice cada empresa sobre él, qué muestran esos logs, para qué sirve y cómo escribir el tuyo, con una plantilla descargable y nuestro archivo comentado por bloques.
¿Qué es llms.txt?
llms.txt es una propuesta de estándar sin respaldo formal de ningún organismo: un fichero de texto en formato Markdown, servido en /llms.txt, que resume de qué trata una web y enlaza sus páginas principales con una línea de explicación cada una. Lo propuso Jeremy Howard el 3 de septiembre de 2024 en llmstxt.org, y la versión 2 de la especificación se publicó el 10 de agosto de 2026. La idea de partida es práctica: una página web está pensada para una persona con navegador, con menús, scripts y publicidad, y un modelo que la lee tiene una ventana de contexto limitada. El archivo le da el resumen y el mapa en un formato que entiende sin procesar HTML. La propuesta añade una segunda convención: ofrecer cada página también en Markdown, en la misma URL terminada en .md, para que un agente pueda leer el contenido limpio sin la maqueta.
La especificación solo exige una cosa: un título H1 con el nombre del proyecto o de la web. Todo lo demás es opcional y va en este orden: una cita (la línea que empieza por >) con el resumen en una o dos frases, párrafos con el contexto que haga falta, y secciones H2 con listas de enlaces en el formato [nombre](url): nota. Una sección llamada «Optional» marca lo que un agente puede saltarse si va corto de contexto. Existe también llms-full.txt, un volcado con el texto completo de la web en un único fichero. No forma parte de la propuesta de llmstxt.org, pero lo publican las documentaciones técnicas de OpenAI, Anthropic y Perplexity, que tienen los dos archivos.
¿En qué se diferencia de robots.txt y del sitemap?
robots.txt da permisos, el sitemap da inventario y llms.txt da contexto: son tres archivos en la raíz con tres destinatarios distintos. robots.txt es un estándar (RFC 9309) que dice a cada rastreador qué puede leer, y los rastreadores automáticos de Google, OpenAI, Anthropic y Perplexity declaran respetarlo en su documentación. El sitemap XML lista todas las URL indexables para que un buscador no se deje ninguna. llms.txt elige unas pocas, las explica en lenguaje natural y ningún motor de búsqueda se ha comprometido a leerlo.
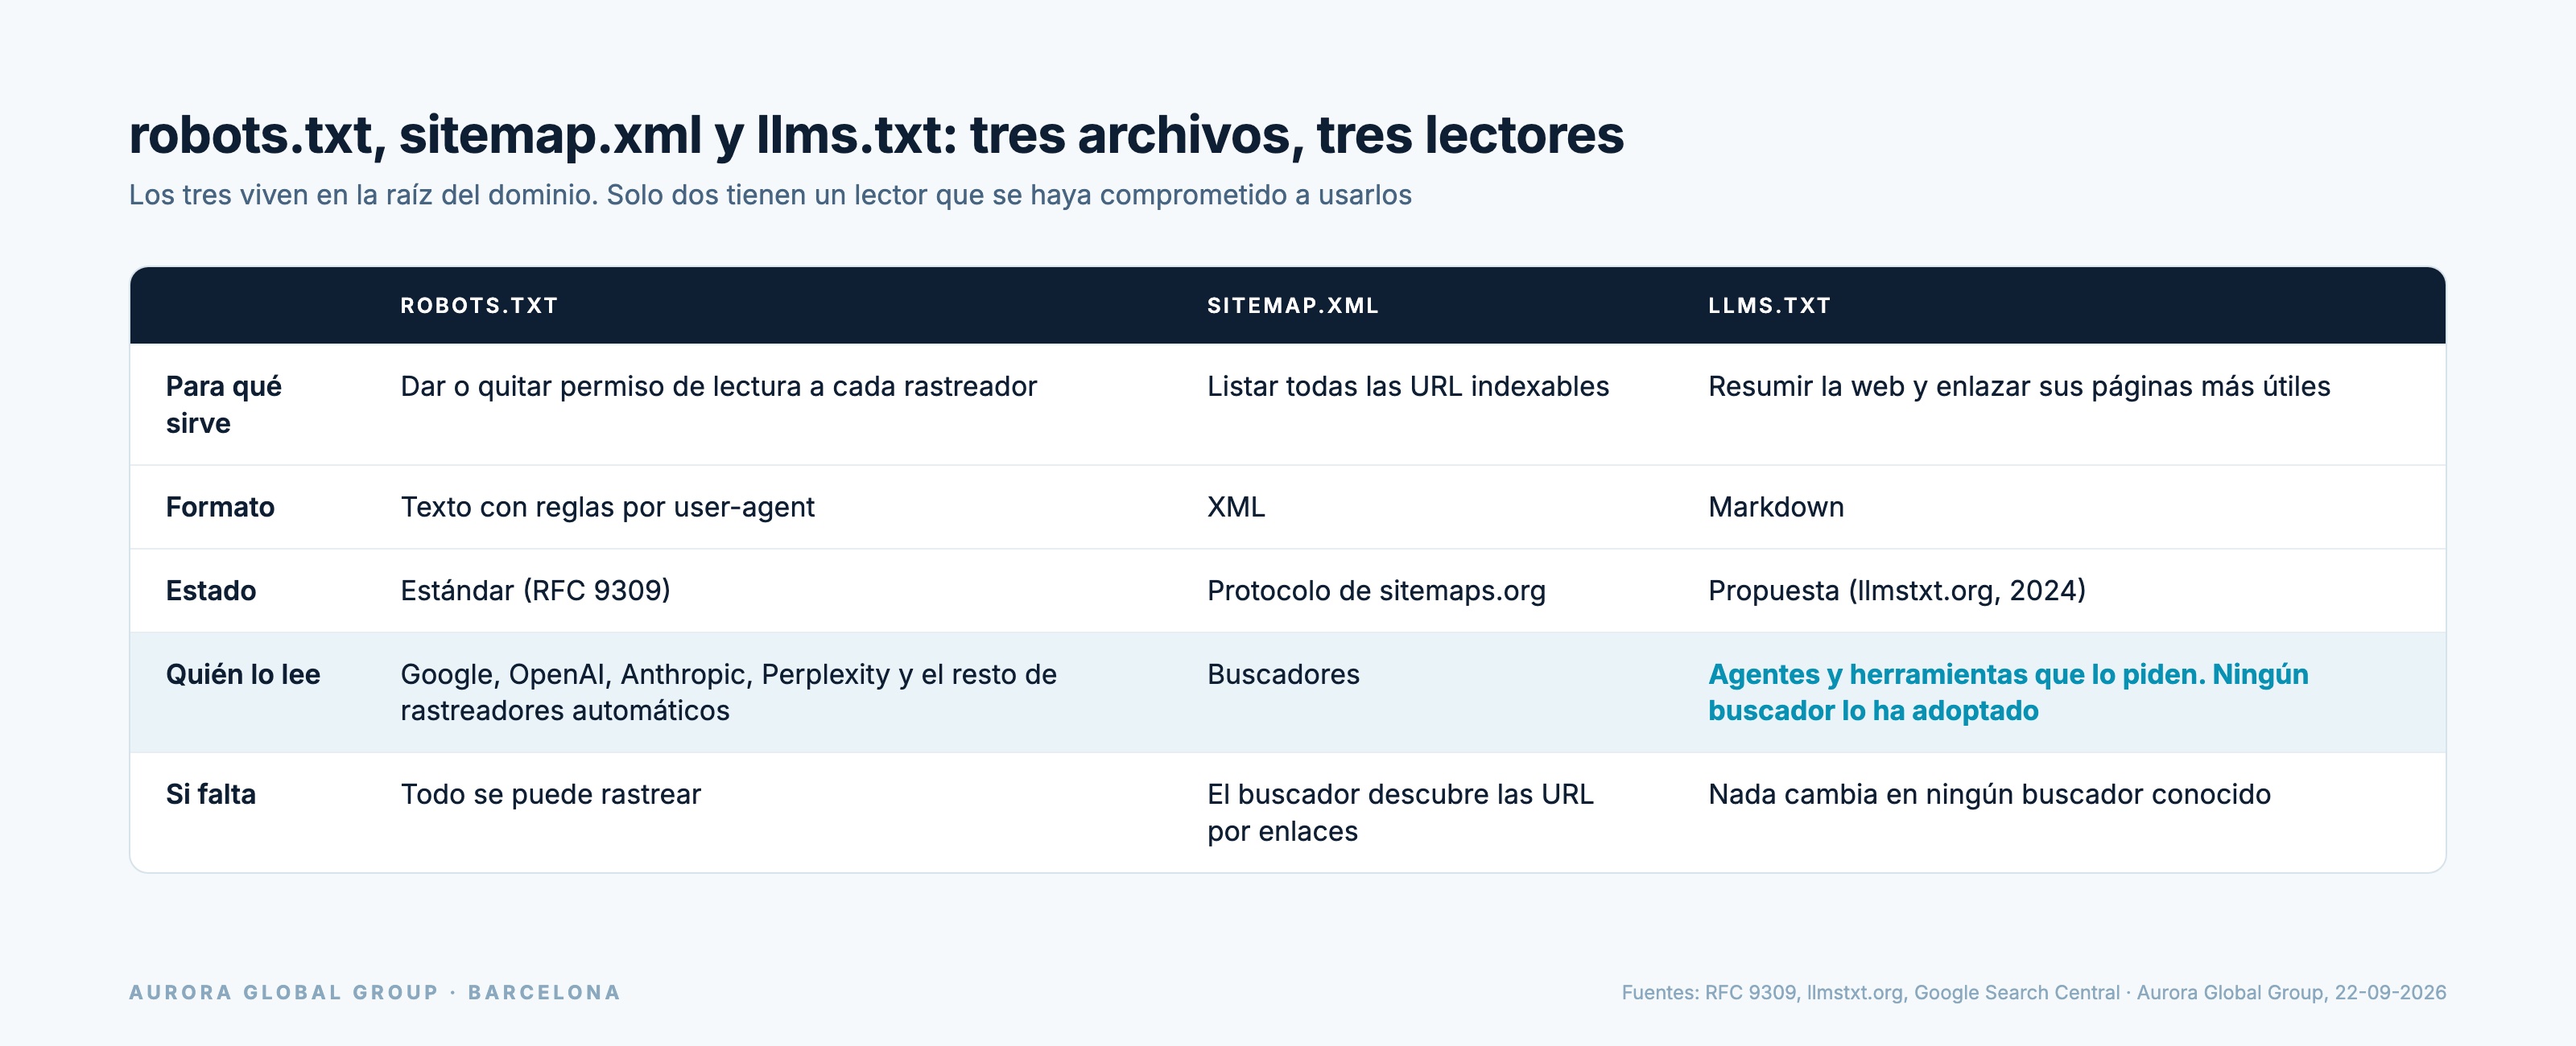
Del orden de importancia no hay duda. Si robots.txt bloquea a los rastreadores de IA, llms.txt no sirve de nada, porque el modelo no puede abrir las páginas a las que apunta. Lo primero que revisamos en cualquier auditoría es que robots.txt deje pasar a los bots que responden preguntas (OAI-SearchBot, ChatGPT-User, Claude-SearchBot, Claude-User, PerplexityBot) y que el servidor les devuelva la misma página que a una persona. Lo explicamos con detalle en SEO para IA.
¿Qué motores de IA leen llms.txt hoy?
Ninguno de los grandes ha dicho que lo use para buscar ni para citar, y Google ha dicho por escrito que no. Su guía oficial sobre las funciones de IA en la búsqueda lo deja claro: no hace falta crear archivos legibles por máquinas, archivos de texto para IA ni marcado especial para aparecer en AI Overviews o en el modo IA. John Mueller, de Google, fue más allá en junio de 2026: calificó llms.txt de «puramente especulativo por ahora», porque el archivo existe desde hace años y ningún sistema de IA lo usa. En enero ya había respondido «no» a la pregunta de si publicar llms.txt en propiedades de Google equivalía a respaldarlo. OpenAI, Anthropic y Perplexity no se han pronunciado. Sus páginas sobre rastreadores explican cómo controlarlos con robots.txt y en ningún punto dicen que lean el llms.txt de las webs que visitan.
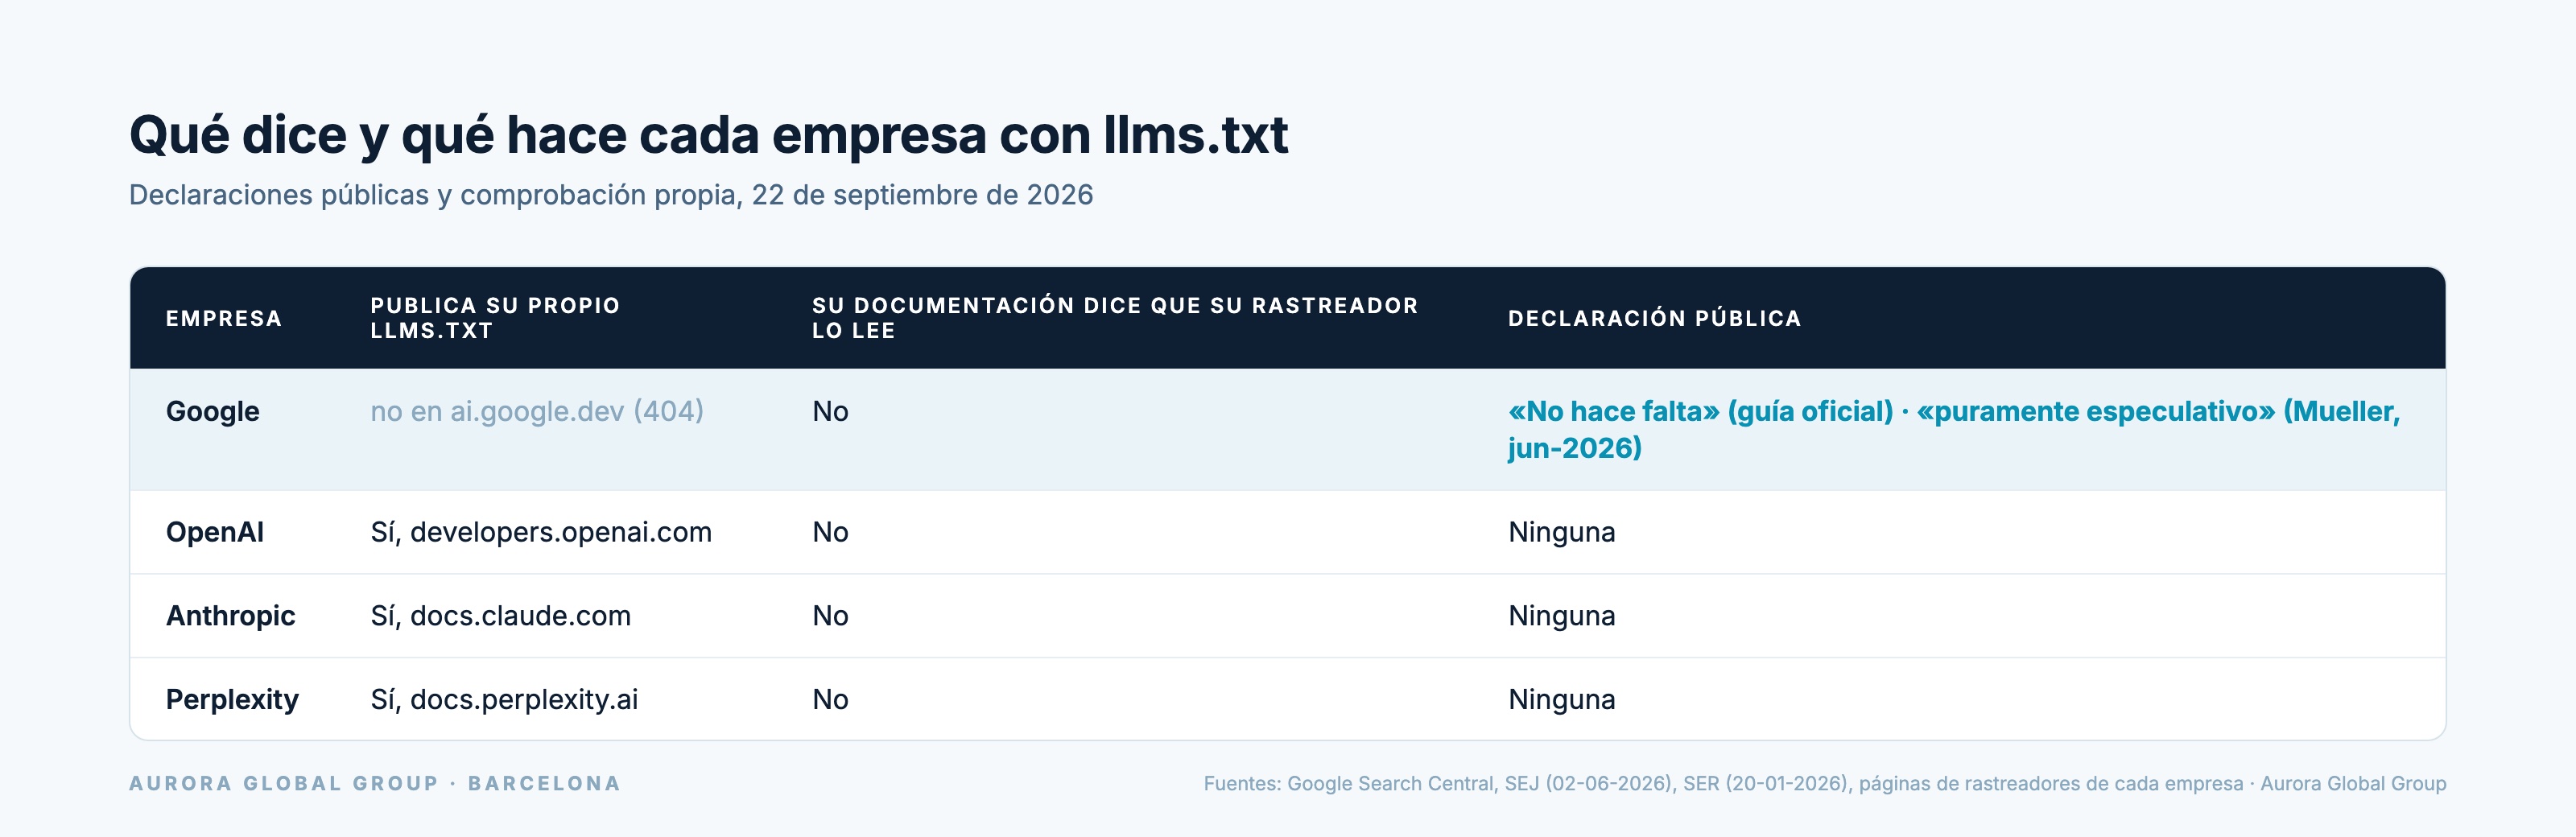
La paradoja es que esas tres empresas publican su propio llms.txt. Lo comprobamos hoy: developers.openai.com/llms.txt, docs.claude.com/llms.txt y docs.perplexity.ai/llms.txt responden 200, y los tres acompañan a un llms-full.txt de varios megas. La explicación es de uso: los desarrolladores cargan esa documentación en asistentes de programación como Cursor o Claude Code, y un índice en Markdown les ahorra trabajo. Hay una segunda señal en la misma línea. Lighthouse, la herramienta de auditoría de Chrome, ya comprueba si una web tiene llms.txt dentro de sus revisiones para navegación con agentes, y su user-agent aparece dos veces en nuestros logs pidiendo el archivo.
¿Cuántas veces piden los bots de IA nuestro llms.txt?
Ninguna en diecinueve días. Entre el 4 y el 22 de septiembre de 2026, los logs de auroraglobalgroup.com registran visitas diarias de GPTBot, OAI-SearchBot y ChatGPT-User (OpenAI), ClaudeBot, Claude-SearchBot y Claude-User (Anthropic) y PerplexityBot y Perplexity-User (Perplexity): más de dos mil peticiones en total, repartidas por el blog, los servicios y los casos. Ninguna fue a /llms.txt ni a /llms-full.txt. Googlebot tampoco lo pidió. De los rastreadores de modelos, solo CCBot, el de Common Crawl, lo descargó una vez: es el que construye el corpus abierto con el que se entrenan muchos modelos, y no responde preguntas de nadie.
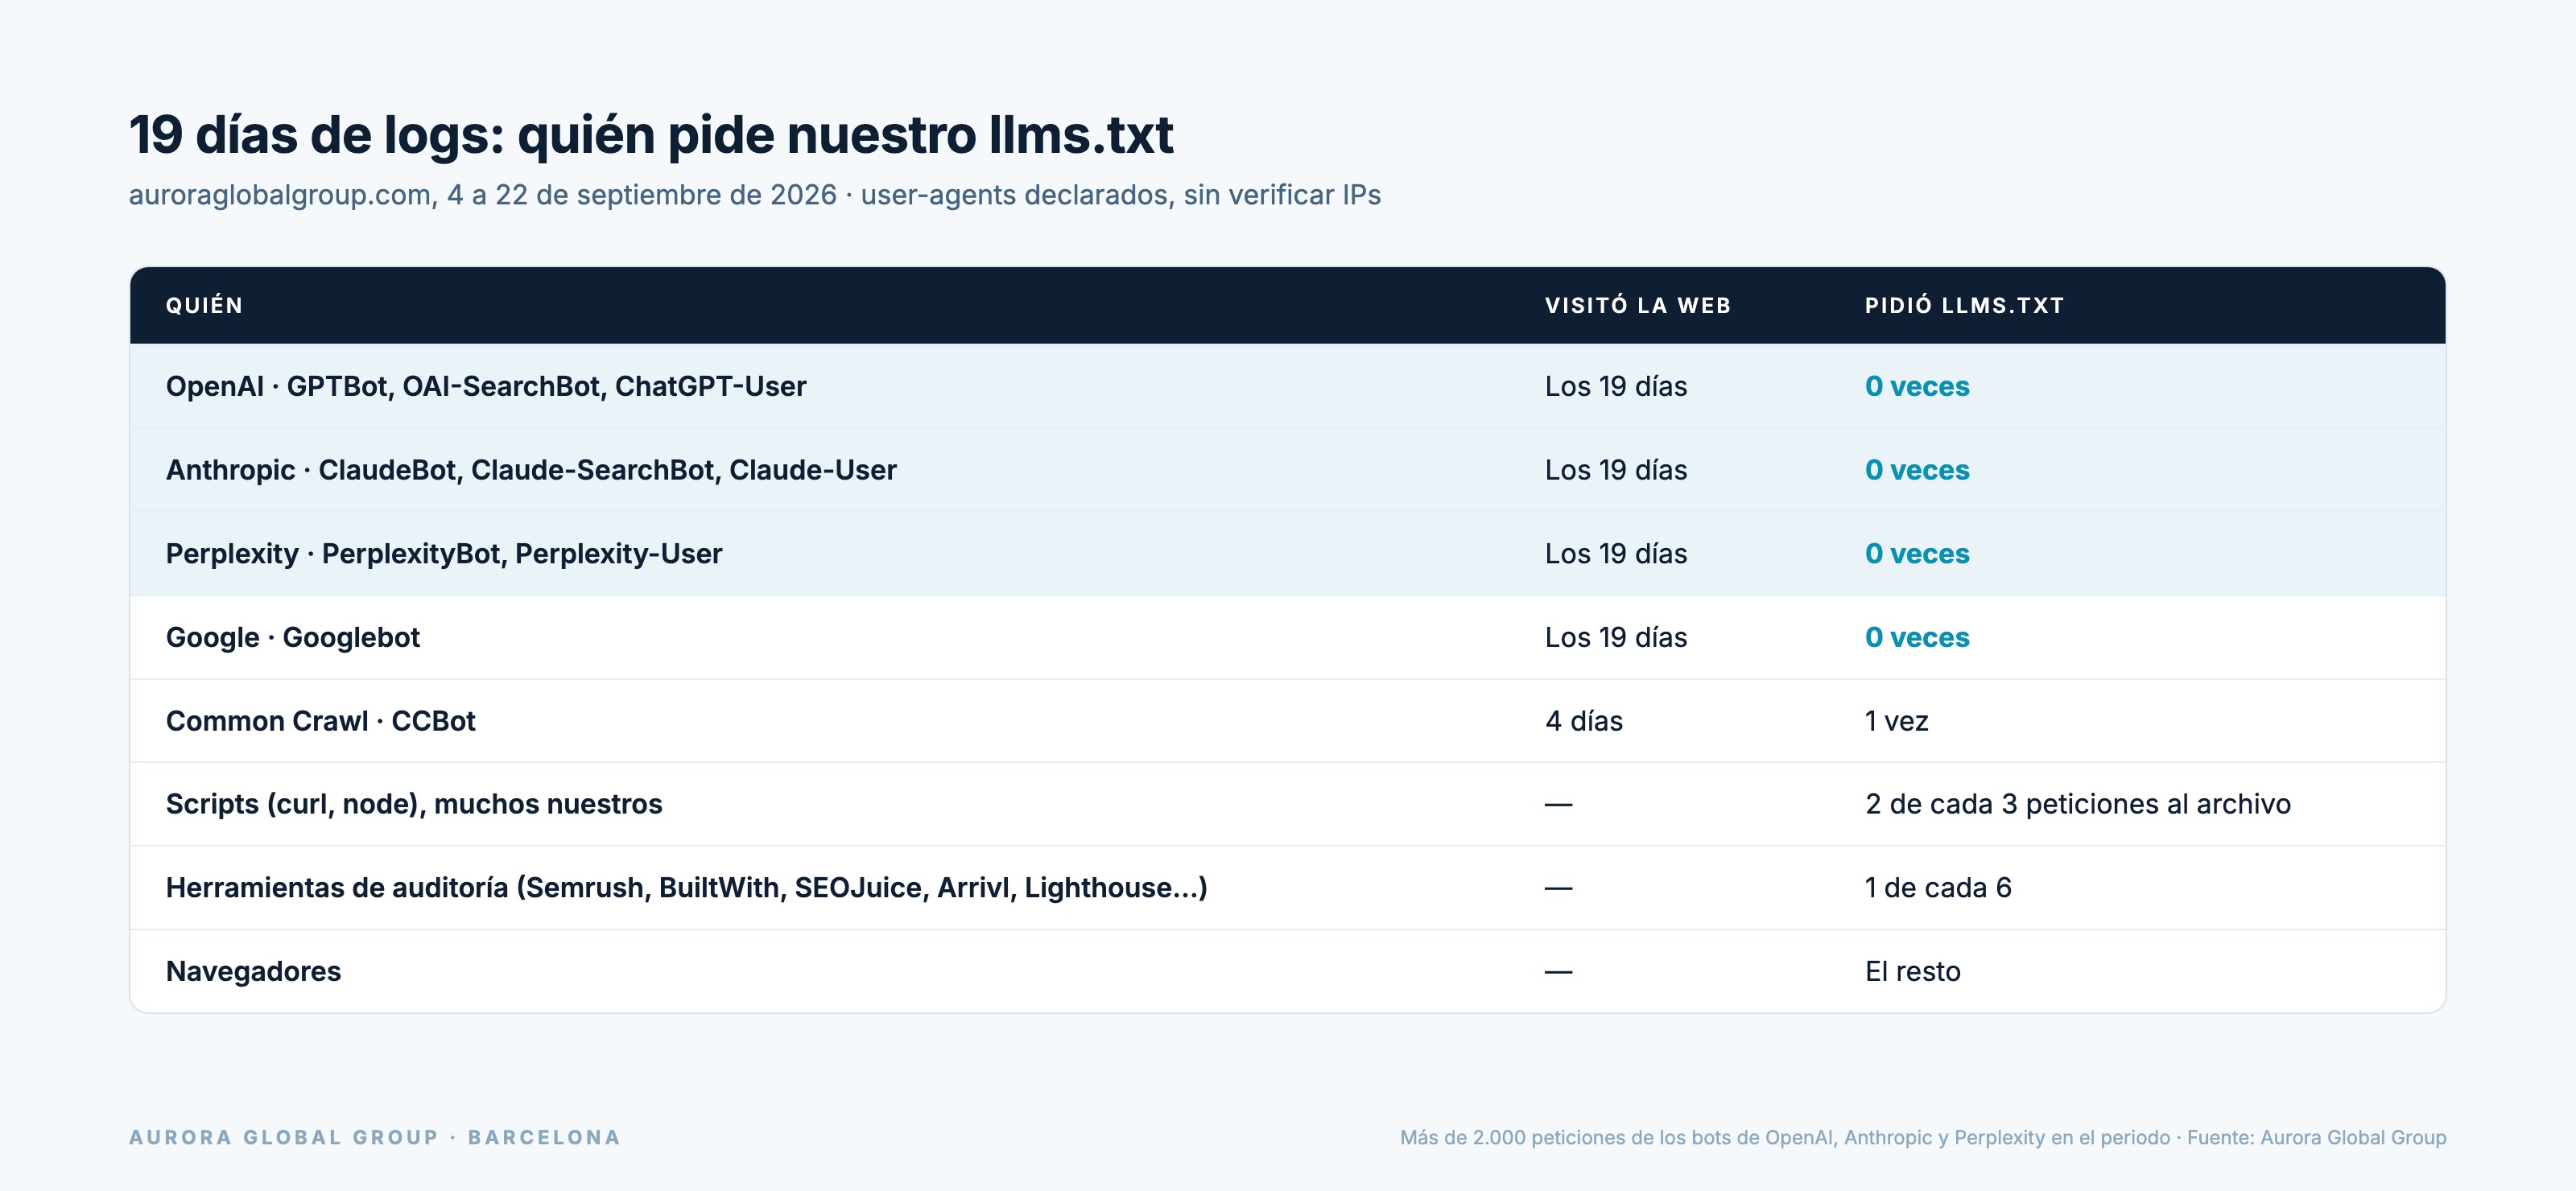
¿Quién lo pidió, entonces? Dos de cada tres peticiones fueron scripts (curl y node), buena parte de ellos comprobaciones nuestras. Una de cada seis vino de herramientas de auditoría y análisis de webs que revisan si existe: Semrush, BuiltWith, SEOJuice, Arrivl, GEO-Brain, Lighthouse. El resto fueron navegadores, es decir, personas que lo abrieron a mano. Hoy el archivo lo leen sobre todo quienes auditan webs para GEO. Los comandos para hacer este mismo recuento en tu servidor están en cómo saber si ChatGPT cita tu web. Basta con cambiar la ruta que se busca por /llms.txt.
¿Para qué sirve llms.txt entonces?
Sirve a los agentes de IA que leen una web por encargo de alguien, y en eso tiene un uso real. Cuando alguien pide a un asistente que lea tu web para preparar una reunión, comparar proveedores o integrar tu API, el agente que encuentra un índice limpio trabaja mejor que el que tiene que adivinar la estructura desde el menú. Por eso lo publican las documentaciones técnicas, y por eso tiene más sentido cuanto más técnico es el producto: un SaaS con API, una tienda con catálogo largo o una empresa con fichas técnicas. Para una web corporativa de veinte páginas, el efecto medible hoy es cercano a cero.
Nuestra postura es la misma desde la guía completa de GEO: lo publicamos porque cuesta poco, no perjudica y queda disponible para el agente que lo busque, pero no lo vendemos como palanca para salir en ChatGPT. Lo que mueve la citación es otra cosa, y lo explicamos en qué es el GEO: contenido con respuestas extraíbles, datos con fuente, rastreadores con acceso y autoridad fuera de tu propia web. Cuando revisamos una web dentro del servicio de GEO, llms.txt ocupa una línea del informe. El acceso de los bots y la estructura de las respuestas ocupan el resto.
¿Cómo crear un llms.txt paso a paso?
Se crea en cinco pasos y sin herramientas: un editor de texto y acceso a la raíz del dominio.
- Elige las páginas. Entre diez y cuarenta: servicios o productos, casos, las guías que mejor responden a las preguntas de tus clientes y contacto. Si una página no la enlazarías en un email a un cliente, fuera.
- Escribe el título y el resumen.
# Nombre de la empresay, debajo, una línea que empiece por>con qué haces, para quién y desde dónde, con algún dato comprobable. - Agrupa en secciones H2.
## Servicios,## Casos,## Guías. Cada línea sigue el formato- [Título](URL absoluta): qué encontrará ahí, en una frase con datos. - Publica en la raíz. El archivo va en
https://tudominio.com/llms.txt, servido como texto plano (text/plainotext/markdown) y en UTF-8, para que las tildes no se rompan. - Comprueba que se lee. Ábrelo en el navegador, revisa que responde 200 y que ningún enlace da 404, y comprueba si tu llms.txt se lee con el test de citabilidad, que además revisa robots.txt.
La plantilla que usamos está aquí, lista para copiar o descargar:
# Nombre de la empresa

> Qué hace la empresa, para quién y desde dónde, en una o dos frases con un dato comprobable.

## Servicios

- [Servicio 1](https://tudominio.com/servicio-1/): qué incluye y para quién es.
- [Servicio 2](https://tudominio.com/servicio-2/): qué incluye y para quién es.

## Casos

- [Caso 1](https://tudominio.com/casos/caso-1/): sector y resultado con cifra.

## Guías

- [Guía 1](https://tudominio.com/blog/guia-1/): qué pregunta responde.

## Optional

- [Sobre nosotros](https://tudominio.com/sobre/): historia, sede y equipo.
- [Contacto](https://tudominio.com/contacto/): cómo y en cuánto tiempo respondéis.
En WordPress lo generan Yoast SEO y Rank Math, que lo rellenan a partir de tus entradas y páginas publicadas y dejan elegir qué incluir. Si lo usas, revisa la salida y quita lo que sobre: un índice sirve cuando alguien ha elegido qué va en él. Tres errores que vemos a menudo: enlaces relativos que el agente no puede resolver, descripciones copiadas de la meta description que no dicen nada, y un archivo que nadie actualiza después de cambiar la web.
¿Cómo es un llms.txt real? El de Aurora, comentado
Un llms.txt real es corto, con hechos en cada línea y actualizado con la web. El nuestro es auroraglobalgroup.com/llms.txt: unos 18 KB, en español con una sección en inglés, y sigue la especificación al pie de la letra. Lo desglosamos por bloques:
# Aurora Global Group. El único campo obligatorio.- La cita con
>. Qué somos (agencia de marketing digital e inteligencia artificial), dónde estamos (Barcelona), cuánto tiempo llevamos (más de quince años), qué hacemos y cómo lo medimos. Es la frase que un agente copiaría si le piden describirnos en una línea, así que lleva hechos y ningún adjetivo. ## Servicios. El índice de servicios y las ocho páginas de servicio, cada una con su promesa concreta: honorarios fijos en paid media, auditoría inicial en SEO y GEO, diagnóstico previo en IA.## Casos de éxito. Once casos, cada uno con su cifra principal en la propia línea (357 leads, 613 candidaturas a 8 euros, del 21,9 % al 42 % de apertura). Si un agente solo lee el índice, se lleva el dato sin abrir la página.## La agencia. Home, método, contacto, Aurora Health y quiénes somos: las páginas que sitúan a la empresa antes de que el agente entre en un servicio.## Blogy## Herramientas. Las guías que responden a preguntas reales y el test de citabilidad, con lo que hace y lo que no hace.## Contacto y perfiles. Email, sede y LinkedIn en tres líneas sin enlazar, para que el agente no tenga que abrir la página de contacto.## English version (US). La web tiene gemela en inglés; la sección repite la estructura en bloques (agencia, servicios, herramientas, casos y blog) y apunta a las páginas equivalentes, para que un agente que trabaja en inglés no traduzca por su cuenta.## Contenido completo. El enlace allms-full.txt, con el texto íntegro de la web en un fichero.
El llms.txt se actualiza cada vez que publicamos una página, en el mismo paso que el sitemap y con el mismo commit.
Preguntas frecuentes
¿llms.txt mejora el posicionamiento en Google?
No. Google declara en su guía oficial que no hace falta ningún archivo de texto para IA para aparecer en AI Overviews o en el modo IA, y que la búsqueda no los usa. El posicionamiento depende de lo mismo que antes: contenido útil, rastreable e indexable.
¿ChatGPT lee llms.txt?
No hay constancia pública. La documentación de OpenAI sobre sus rastreadores explica cómo controlarlos con robots.txt y no dice que lean llms.txt, y en nuestros logs ningún bot de OpenAI lo pidió en diecinueve días. ChatGPT sí puede leerlo si alguien le pasa la URL directamente.
¿Es obligatorio tener llms.txt?
No. Es una propuesta de estándar sin adopción oficial por parte de los motores. Tenerlo no perjudica, y no tenerlo no te resta visibilidad en ningún buscador conocido hoy.
¿Qué diferencia hay entre llms.txt y llms-full.txt?
llms.txt es un índice con enlaces y una línea por página. llms-full.txt contiene el texto completo de la web en un solo fichero, para que un agente lo cargue de una vez. El segundo no forma parte de la propuesta original.
¿Sirve llms.txt para impedir que la IA use mi contenido?
No. llms.txt no da ni quita permisos: eso lo hace robots.txt, con una regla por rastreador (GPTBot, ClaudeBot, CCBot…). Si quieres separar el uso para buscar del uso para entrenar modelos, bloquea solo los rastreadores de entrenamiento y deja pasar a los que responden preguntas.
¿Dónde se pone el archivo llms.txt?
En la raíz del dominio, en https://tudominio.com/llms.txt, como texto plano en UTF-8. La especificación admite también subrutas, como /docs/llms.txt, para documentaciones que viven en una sección de la web.
¿Cada cuánto hay que actualizarlo?
Cada vez que cambian las páginas que enlaza: una página nueva de servicio, un caso publicado o una URL que cambia. Un llms.txt con enlaces rotos es peor que no tenerlo, porque manda al agente a un 404.
Jeremy Howard, The /llms.txt file, llmstxt.org (propuesta del 3-09-2024, versión 2 del 10-08-2026). Consultado el 22-09-2026.
Google Search Central, Funciones de IA y tu sitio web. Consultado el 22-09-2026.
Search Engine Journal, Google says LLMs.txt is purely speculative for now, 2-06-2026 (declaraciones de John Mueller).
Search Engine Roundtable, Google Search Team Does Not Endorse LLMs.txt Files, 20-01-2026.
OpenAI, Overview of OpenAI Crawlers (developers.openai.com); Anthropic, página de ayuda sobre ClaudeBot, Claude-User y Claude-SearchBot (support.claude.com); Perplexity, Perplexity Crawlers (docs.perplexity.ai). Consultadas el 22-09-2026.
Yoast, llms.txt (yoast.com/features/llms-txt) y Rank Math, How to Use llms.txt in Rank Math SEO (rankmath.com/kb/llms-txt). Consultadas el 22-09-2026.
IETF, RFC 9309, Robots Exclusion Protocol.
Comprobación propia de developers.openai.com/llms.txt, docs.claude.com/llms.txt y docs.perplexity.ai/llms.txt (respuesta 200), 22-09-2026.
Logs de acceso del servidor de auroraglobalgroup.com, 4 a 22 de septiembre de 2026.
Cómo lo trabajamos en Aurora
Si quieres saber si tu llms.txt existe, se sirve bien y deja pasar a los bots que importan, el test de citabilidad IA lo comprueba gratis en veinte segundos, junto con robots.txt y los datos estructurados.
Si lo que quieres es que la IA te cite, el archivo es lo último que tocamos. Primero medimos en qué preguntas de tu sector apareces y quién sale en tu lugar; es la primera medición de nuestro servicio de GEO.